- 会員限定
- 2026/09/04 07:10 掲載
AIOpsとは何かを超わかりやすく解説、MLOpsやDevOpsとどう違うの?


AIOps(エーアイオプス)とは、AIを使ってITシステムの運用を助ける仕組みです。大量のログやアラートをAIが仕分け、異常を見つけ、原因を絞り込み、復旧までを支援・自動化します。クラウドの普及でシステムが複雑になり、人の目だけでは追い切れなくなったことが背景にあります。この記事では、AIOpsでできることや仕組み、MLOps・DevOpsとの違い、ツールの選び方、導入手順までを、1つの例を使ってやさしく解説します。
AIOpsとは何か?まず知っておきたい基本
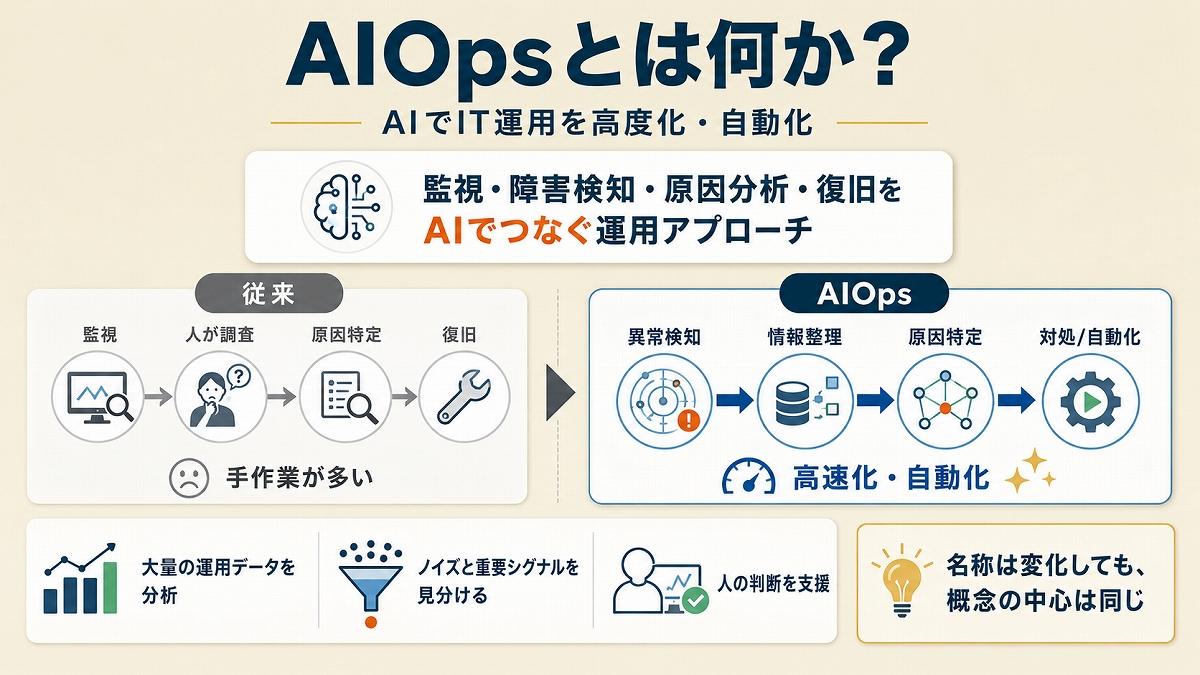
AIOpsとは、ひと言でいえば「AIを使ってITシステムの運用を助ける仕組み」です。「Artificial Intelligence for IT Operations」の略で、一般に「エーアイオプス」と読みます。イメージとしては、運用チームに加わった「優秀な助手」です。システムから届く大量の警報(アラート)を仕分け、どこで何が起きているのかを調べ、原因の当たりを付けて担当者に知らせます。あらかじめ決めた範囲であれば、復旧作業まで代わりに実行します。
AIOpsの働きは、次の3段階で考えるとわかりやすくなります。
1.見つける:普段と違う動きにいち早く気づく
2.絞り込む:関連する情報をまとめ、原因の候補を絞る
3.対処する:担当者に知らせる、または自動で復旧する
この記事では、この3段階を軸に説明していきます。あわせて「ある夜、ECサイトの表示が急に遅くなった」という場面を、例として繰り返し使います。
従来のIT運用では、監視ツールが異常を知らせた後、人間が大量のログ(システムの動作記録)を調べ、原因を特定し、復旧作業を行うのが一般的でした。一方、AIOpsでは、その途中にAIが入り、この3段階の作業を高速化します。
ベンダー各社の説明も、表現は違いますが中身はほぼ共通しています。Red Hatは、システムがリアルタイムで「観察し、学習し、行動する」ための仕組みだと説明します。IBMは、大量の運用データから「ノイズ」と「重要なシグナル」を分ける役割を担うとしています。Google Cloudも、異常の特定、原因の発見、将来起こり得る問題の予測に使われると説明しています。
つまり、「大量の運用データをAIで分析し、人間が行ってきた判断や対応を支援・自動化する」という点は、どの会社の説明でも変わりません。
なお、タイトルの疑問に先に答えておくと、よく似た言葉との違いは次のとおりです。
・AIOps:AIを「使って」ITシステムを運用する
・MLOps:AI(機械学習モデル)「そのもの」を運用する
・DevOps:開発と運用が連携し、ソフトウェアを速く安定して届ける
詳しくは、後半の「AIOpsとMLOps・DevOps・オブザーバビリティの違い」で説明します。
なぜAIOpsが必要なのか
AIOpsが必要とされる最大の理由は、IT環境が人間だけでは把握しにくいほど複雑になったことにあります。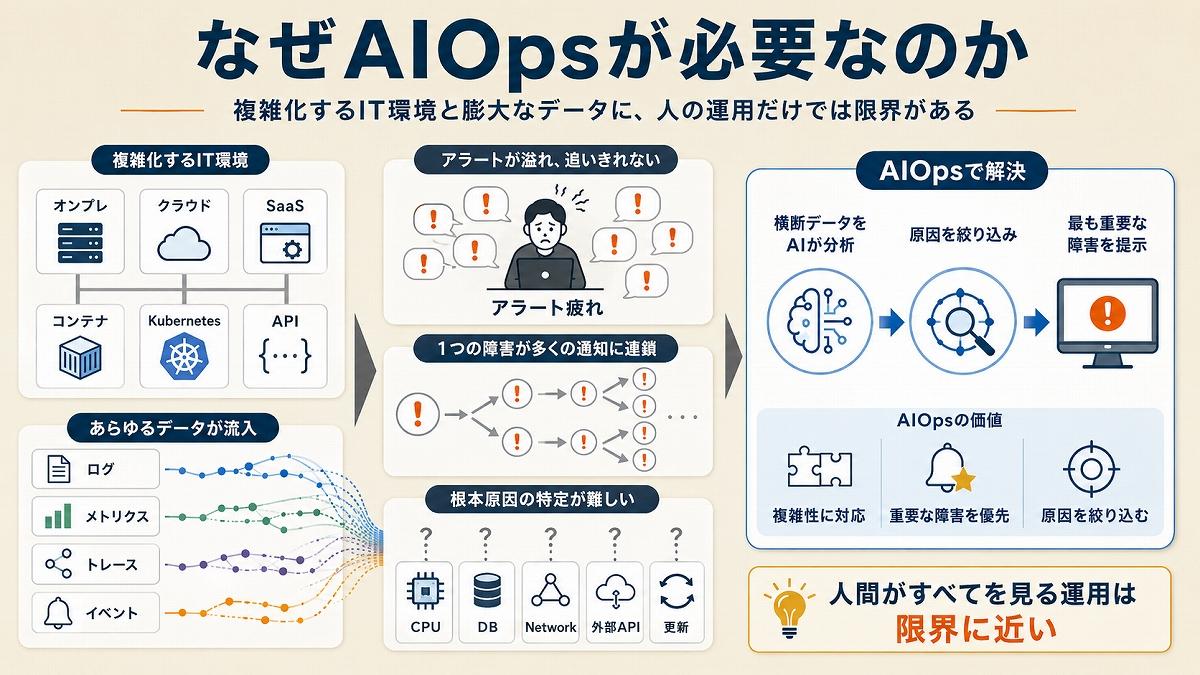
現在の企業システムは、自社で保有するサーバ(オンプレミス)だけでは完結しません。AWS、Microsoft Azure、Google Cloudなどのクラウド、SaaS、外部のAPIなどが組み合わされています。アプリケーション自体も、小さなサービスを多数つなげてつくる「マイクロサービス」や、それを動かす「コンテナ」「Kubernetes」といった技術の利用が広がりました。
冒頭のECサイトで考えてみましょう。利用者から見れば1つのサイトですが、その裏では商品検索、在庫、決済、配送といった多数のアプリケーションやデータベース、ネットワーク、外部サービスが連携しています。
そして、それぞれが次のような「運用データ」を出し続けます。
| 運用データ | 中身 | ECサイトでの例 |
| ログ | システムが出す動作の記録 | 「決済処理でエラーが発生」という記録 |
| メトリクス | 数値で測れる状態 | CPU使用率、ページの応答時間 |
| トレース | 1つの処理がどのサービスを通ったかの記録 | 注文ボタンを押してから完了までの経路 |
| イベント | システムに起きた出来事 | アプリの更新、設定の変更、警告の発生 |
Splunkは、こうした環境の普及によって大量のログや性能データが生まれ、人間のIT担当者だけでは管理が困難になっていると説明します。
そこで起きるのが、いわゆる「アラート疲れ」です。100件のアラートが来たからといって、100件の障害が発生しているとは限りません。1つのネットワーク障害が関連するアプリやデータベースに影響し、大量の通知を発生させているだけかもしれないのです。人間が1件ずつ調べていれば、本当に重大な障害への対応が遅れてしまいます。
さらに厄介なのが、原因の特定です。「ECサイトが遅い」という現象1つをとっても、原因はCPU不足かもしれませんし、データベースへの問い合わせ(クエリ)かもしれません。ネットワーク、外部API、直前のアプリ更新が原因の場合もあります。
だからこそ、大量の運用データを横断的に分析し、「最初にどこで異常が起きたか」「どの障害がどこまで影響しているか」をAIで絞り込む必要があります。
AIOpsが必要なのは、単にIT人材を減らすためではありません。人間がすべての情報を見ることを前提にしたIT運用そのものが、限界に近づいているからです。
AIOpsで何ができる?代表的な7つの機能
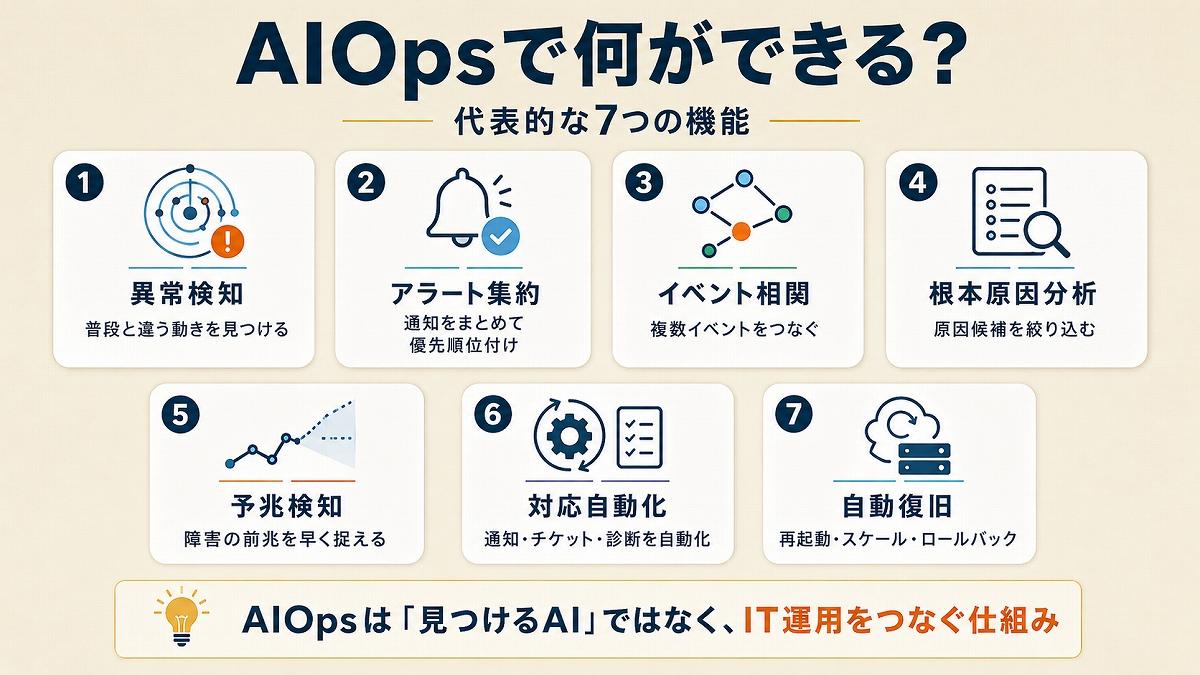
AIOpsを理解する近道は、「結局、何をしてくれるのか」を見ることです。代表的な機能は7つあり、冒頭の3段階に分けると次のように整理できます。| 段階 | 機能 | ひと言でいうと |
| 見つける | 1.異常検知 | 普段と違う動きに気づく |
| 見つける | 2.予兆検知 | 障害になりそうな兆しをつかむ |
| 絞り込む | 3.アラートの集約・優先順位付け | 大量の通知を1件にまとめる |
| 絞り込む | 4.イベント相関 | 別々の出来事を結び付ける |
| 絞り込む | 5.根本原因分析(RCA) | 大本の原因を突き止める |
| 対処する | 6.インシデント対応の自動化 | 通知や調査の準備を自動で行う |
| 対処する | 7.自動復旧 | 安全な範囲で自動的に直す |
見つける
1つ目は「異常検知」です。従来の監視では「CPU使用率が90%を超えたら警告する」といった、固定の基準値(しきい値)が多く使われてきました。一方、AIOpsは過去のデータから通常時の状態を学び、「普段とは違う動き」を見つけます。ECサイトなら「平日の深夜にしては応答が遅い」といった気づきです。
2つ目は「予兆検知」です。過去の傾向とリアルタイムのデータを組み合わせ、「このまま推移すると容量不足になる」「応答の悪化が障害につながる」といった兆候を早めに捉えます。
絞り込む
3つ目は、アラートの集約と優先順位付けです。1つの障害によって、サーバ、ネットワーク、アプリケーションなどから大量のアラートが発生する場合があります。AIOpsは発生時刻やシステム同士の関係を分析し、関連する通知を1つのインシデント(対応が必要な障害や不具合)としてまとめます。
4つ目は「イベント相関」です。アラートの集約が「同じ障害の通知をまとめる」作業だとすれば、イベント相関は「別々のツールが記録した出来事を結び付ける」作業にあたります。たとえば「アプリの更新」と「データベースの負荷上昇」を結び付け、「同じ原因から起きている可能性が高い」と判断します。
5つ目は根本原因分析、いわゆるRCA(Root Cause Analysis)です。表面に見えている現象ではなく、大本の原因を突き止めます。Dynatraceは、ITシステムの各層のデータを取り込み、継続的にAIで分析することで、問題の特定、根本原因の把握、修復の自動化につなげられるとしています。
対処する
6つ目は、インシデント対応の自動化です。異常を見つけた後、担当チームへの通知、チケット(対応依頼の記録)の発行、調査用プログラムの実行などを自動で行います。
7つ目は「自動復旧」です。事前に安全性を確認した処理であれば、サービスの再起動、リソース(サーバなどの処理能力)の追加、直近の変更を元に戻す「ロールバック」まで自動的に実行できます。
こうして見ると、AIOpsは単なる「障害を見つけるAI」ではなく、「IT運用の一連の作業をAIでつなぐ仕組み」だとわかります。
AIOpsの仕組み、「見つける→絞り込む→対処する」はどう動く?
では、AIOpsは実際にどのように動くのでしょうか。Google Cloudは、AIOpsの仕組みを次の3段階で説明しています。・観察:IT環境全体から、メトリクス、ログ、トレース、イベントなどのデータを集める
・連携:機械学習でデータ同士を関連付け、ノイズと重要なシグナルを分ける。関連するアラートをまとめ、異常を検出し、原因候補を絞り込む
・行動:分析結果を基に、担当者への通知から自動修復までを実行する
データを集めて異常や原因を見極め、対処に移るという流れは、この記事の「見つける→絞り込む→対処する」と同じ考え方です。
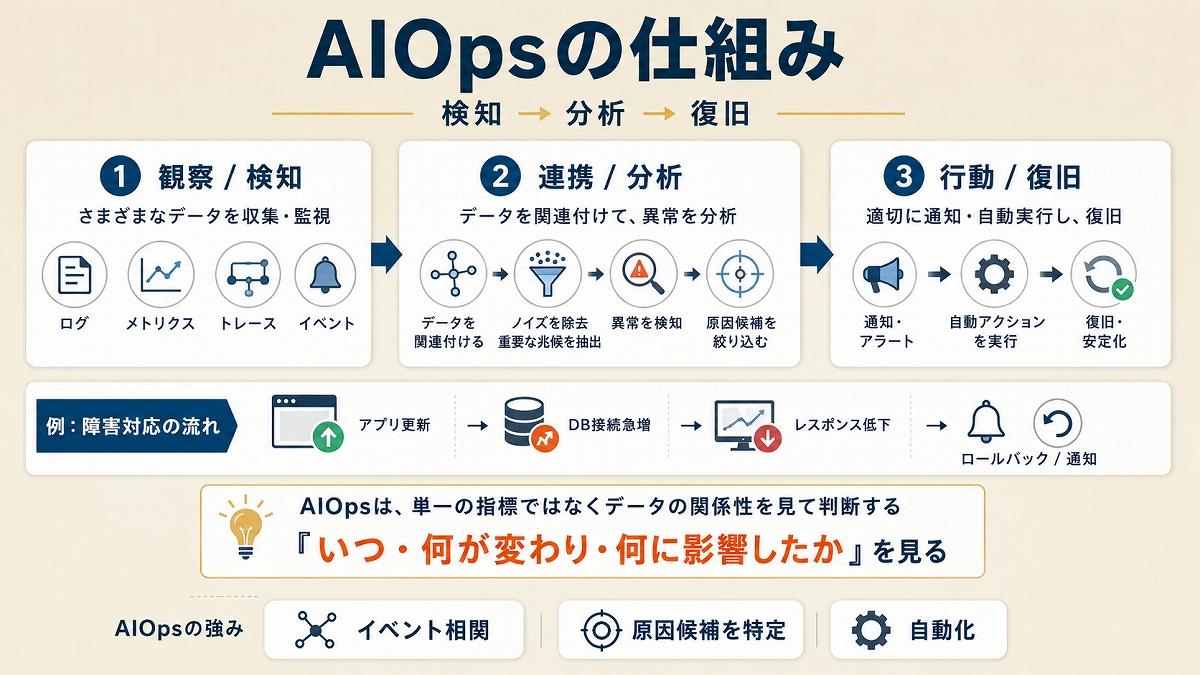
これをECサイトの例に当てはめてみます。ある夜、サイトの表示が急に遅くなったとしましょう。従来の運用とAIOpsを使った運用では、次のように変わります。
| 段階 | 従来の運用 | AIOpsを使った運用 |
| 見つける | 監視ツールの警告で人間が気づく | 応答時間が「普段と違う」ことをAIが検知する |
| 絞り込む | 人間が大量のログを調べ、原因を特定する | AIが複数のデータを突き合わせ、原因候補を示す |
| 対処する | 人間が復旧作業を行う | 条件に従い、担当者へ通知するか自動で復旧する |
もう少し詳しく見てみましょう。AIOpsはまず、応答時間、CPU、メモリー、データベース、ネットワーク、アプリケーションのログなどを確認します。そこで、表示が遅くなる直前にデータベースへの接続数が急増し、同時に特定のエラーログが増えていたことを見つけたとします。さらに、その直前にアプリケーションが更新されていれば、変更履歴も加えて分析します。
その結果、「アプリの更新後にデータベースへの接続が急増し、それが表示の遅れにつながっている可能性が高い」と原因候補を絞り込めます。あとは、あらかじめ設定された条件に従い、担当者へ通知するか、問題のある変更をロールバックします。
重要なのは、AIOpsが1つのデータだけを見ているわけではないことです。CPU使用率だけ、ログだけを見るのではなく、「いつ、何が変わり、その直後に何が起こり、どのサービスへ影響したか」という関係性を見ます。
このデータ同士の結び付き、つまり「相関」こそが、AIOpsの肝です。
AIOpsとMLOps・DevOps・オブザーバビリティの違い
AIOpsについて調べると、MLOpsやDevOps、オブザーバビリティなど、似た言葉が数多く出てきます。違いは「何を運用・管理するのか」で考えるとわかりやすくなります。| 用語 | 主な目的 | 主な対象 |
| AIOps | AIでIT運用を高度化する | ITシステム・運用データ |
| MLOps | 機械学習(ML)モデルを安定して運用する | 機械学習モデル |
| DevOps | 開発と運用を連携する | ソフトウェア開発・運用 |
| オブザーバビリティ | システム内部の状態を理解する | ログ・メトリクス・トレース |
| AgentOps | AIエージェントを管理する | AIエージェント |
特に混同されやすいのが、AIOpsとMLOpsです。簡単にいえば、次の違いがあります。
・AIOps=AIで「ITシステム」を運用する
・MLOps=「AI・機械学習モデルそのもの」を運用する
AIOpsにとってAIは「道具」であり、MLOpsにとってAIは「管理する対象」だと考えると区別しやすいでしょう。
DevOpsは、開発と運用を一体化し、ソフトウェアを継続的かつ高速に提供するための文化やプロセスを指します。AIOpsはDevOpsと競合する考え方ではありません。むしろ、DevOpsによって高速化・複雑化したIT環境を、AIで監視・分析する役割を担います。
オブザーバビリティ(可観測性)との違いも押さえておきましょう。オブザーバビリティは、ログ、メトリクス、トレースなどを通して「システム内部で何が起きているか」を理解できる状態にすることです。一方のAIOpsは、そこで得た大量の情報をAIで分析し、「何が異常なのか」「なぜ起きたのか」「どう対処するか」までつなげます。
医療にたとえるなら、オブザーバビリティは「検査で体の状態を見えるようにすること」、AIOpsは「検査結果を読み解いて、診断と処置につなげること」にあたります。
そしてAgentOpsは、AIエージェント(自律的に判断して作業を進めるAI)自身の運用管理を指します。AIエージェントがリアルタイムで意思決定する際に、その振る舞いや予算、安全性などを管理するための枠組みといえます。
AIOpsのメリットと課題・デメリット
AIOpsのメリットとして最もわかりやすいのが、障害対応の高速化です。IBMは、AIOpsによって複数環境の運用データを相関させ、ノイズを減らしながら根本原因を特定することで、MTTRの短縮につながるとしています。MTTRとは、障害の発生から復旧までにかかる平均時間のことです。また、大量のアラートを整理できれば、運用担当者が本当に重要なインシデントに集中しやすくなります。予兆検知を活用すれば、障害が起きてから動く「事後対応型」から、起きる前に手を打つ「予防型」のIT運用へ近づけます。
さらに、過去のインシデントや対応履歴を分析に使うことで、ベテラン担当者だけに頼っていた障害対応のノウハウを、より広いチームで活用しやすくなります。
一方、AIOpsにも課題があります。最大の問題はデータです。ログが保存されていなかったり、監視ツールごとにデータが分断されていたりすれば、AIが正しく原因を分析することは難しくなります。Google Cloudも、AIOpsの実装ではデータの正確性、完全性、整合性を確保する必要があると指摘しています。
誤検知も避けられません。AIは「普段と違う動き」を異常として捉えるため、セールでアクセスが増えただけの正常な変化を、異常と判断してしまうことがあります。誤った警告が続けば、担当者がAIの通知を信用しなくなるおそれもあります。
さらに、AIが「このサーバを再起動すべき」と判断することと、実際に本番のサーバを再起動することは別の問題です。自動化を進めるほど、次の4点の設計が重要になります。
・AIにどこまでの操作を許すか(実行権限)
・AIが何をしたかをどう記録するか(監査ログ)
・どの操作に人間の承認を挟むか(承認フロー)
・うまくいかなかったときにどう元に戻すか(ロールバック)
メリットと課題を整理すると、次のようになります。
| メリット | 課題 |
| アラートノイズの削減 | データ品質に左右される |
| MTTRの短縮 | 誤検知の可能性 |
| 障害の予兆検知 | 既存ツールとの統合が必要 |
| 属人化の軽減 | 導入・運用スキルが必要 |
| 定型作業の自動化 | 自動実行時の安全性 |
| 運用負荷の削減 | 権限・監査設計が必要 |
「AIを入れれば運用が勝手に自動化される」と考えるのは危険です。
AIOpsの代表的なユースケース
AIOpsは、どのような場面で役立つのでしょうか。ここでは、運用の現場で起こりがちな5つの場面に分けて見ていきます。場面1:通知が多すぎて、重要なものが埋もれる
サーバ、ネットワーク、クラウド、アプリなどから大量の通知が届く場面です。AIOpsは、同じ障害に起因する通知をまとめ、対応すべき順番を示します。使うのは、アラートの集約とイベント相関の機能です。
場面2:障害の原因特定に時間がかかる
原因の調査を人手に頼っていると、復旧までの時間が延びてしまいます。IBMはAIOpsのユースケースとして、AIによるリアルタイムの根本原因分析を利用し、MTTD(異常の発見までにかかる平均時間)やMTTRの短縮につなげる使い方を紹介しています。
場面3:繁忙期にシステムが耐えられるか不安
過去のリソース使用量を分析し、「来月にはCPUの容量が不足する可能性がある」「繁忙期はWebサーバを増やしたほうがよい」といった判断を支援します。
場面4:クラウドの利用料がかさんでいる
リソースが過剰に割り当てられている場合は縮小し、逆に性能不足が予測される場合は増強します。性能とコストのバランスを取る使い方です。
場面5:定型的な障害対応を減らしたい
異常を検知したら、チケットを登録し、担当者へ通知し、必要な診断処理まで走らせます。さらに進めば、サービス停止を検知してプロセスを再起動する、負荷の急増時にリソースを追加する、問題のある変更をロールバックするといった自動修復も可能です。
これらを一度にすべて導入する必要はありません。アラートの整理から始め、根本原因分析、定型作業の自動化、自動修復へと段階的に進めるほうが現実的です。
AIOpsツールとは?代表的な製品と選び方
AIOpsは特定の製品名ではありません。各ベンダーが、オブザーバビリティ、イベント相関、異常検知、根本原因分析、ITSM、自動化などを組み合わせた製品・サービスを提供しています。ITSMとは「ITサービス管理」のことで、問い合わせや障害をチケットとして受け付け、対応状況を管理する仕組みを指します。代表的なプレーヤーとしては、IBM、ServiceNow、Splunk、Dynatrace、Datadog、Red Hatなどがあります。ただし、「AIOpsツール」という名前だけで横並びに比較するのは難しいのが実情です。各社で得意な領域が異なるためです。
たとえばServiceNowは、IT運用管理(IT Operations Management)の製品の中で、イベント相関、異常検知、根本原因分析などを提供しています。Splunkは、イベント管理、予測分析、インシデントの優先順位付けなどをAIOps用途として展開します。一方、DynatraceはオブザーバビリティとAIを組み合わせ、異常検知や根本原因分析、環境の自動検出などに強みを置いています。
つまり、「どのAIOpsが一番良いか」ではなく、自社は何に困っているかから考える必要があります。
| 製品・サービス | 主な強み | こんな企業に向く |
| IBM | 複数環境の運用データの相関、ノイズ削減 | アラートが多すぎて重要な通知が埋もれている |
| ServiceNow | ITSM・IT運用管理との統合 | すでにServiceNowを使っており、チケット管理と一体で運用したい |
| Splunk | ログ・イベント分析 | 大量のログを扱っている |
| Dynatrace | オブザーバビリティ、根本原因分析 | アプリケーションの監視と原因特定を重視する |
| Datadog | クラウド監視 | クラウドを中心にシステムを構築している |
| Red Hat | 自動化との連携 | Ansibleを使っており、復旧作業の自動化まで進めたい |
悩みから逆算すると、選ぶ基準がはっきりします。アラートが多すぎるなら、イベント相関の機能が重要です。アプリケーション障害の原因特定に時間がかかるなら、オブザーバビリティやRCAの性能が決め手になります。運用の流れ全体を自動化したいなら、ITSMや自動化ツールとの連携を重視すべきでしょう。
対象範囲の広さも判断材料です。Google CloudはAIOpsソリューションを、次の2種類に整理しています。
・ドメイン中心型:ネットワーク、アプリ、クラウドなど特定の領域に特化する
・ドメイン非依存型:複数の監視・ITSM・セキュリティツールを横断して分析する
特定の領域から始めるのか、全体を横断して見たいのか。この違いを理解した上で、自社の対象範囲を決める必要があります。
AIOps導入は何から始める?5ステップ
導入も「見つける→絞り込む→対処する」の順に、少しずつ範囲を広げていくのが基本です。Step1:まず「困っていること」を決める
最初からAIOpsの導入を目的にしてはいけません。「アラートを半分にしたい」「障害原因の特定時間を短くしたい」「夜間対応を減らしたい」など、具体的な運用課題を決めます。
Step2:ログやメトリクスを確認する
次に、分析に必要なデータが取れているかを確認します。ログ、メトリクス、トレース、イベントだけでなく、構成情報、変更履歴、過去の障害チケットなども重要です。
Step3:ノイズ削減から始める
最初からAIに本番環境を操作させる必要はありません。関連するアラートの集約や重複通知の削減など、人間の判断を支援する用途から始めるほうが安全です。
Step4:根本原因分析へ広げる
続いて、トポロジ(システム同士のつながりを表した構成情報)や変更情報などを使い、AIに障害原因の候補を提示させます。この段階では、AIが提案し、人間が判断するという運用が基本になります。
Step5:安全な処理から自動化する
最後に、チケットの発行、通知、診断用プログラムの実行、サービスの再起動などを自動化していきます。ガートナーが2026年8月に公開した実装ガイドでも、基本的なノイズ削減から自動対応・修復へ段階的に進むことが重要とされています。
AIOpsは「完全自動化から始める」ものではありません。人間が確認していた作業を、リスクの小さいところから1つずつAIへ移していくのが、現実的な導入方法です。
AIOpsの導入事例、実際どこまで効果が出る?
AIOpsは理論上の考え方にとどまりません。実際の企業でも、アラートの削減や障害対応時間の短縮に使われています。海外の事例
IBMが公開している事例を2つ紹介します。1つ目は、ブラジルの通信事業者Brasil TecParです。同社はネットワーク運用基盤「CORTEX」で、IBM Cloud Pak for AIOpsなどを活用しています。1日最大30万件のアラートを処理しながら、アラートノイズを70%超削減し、光ファイバー断線時のインシデント対応速度を84%改善したといいます。
2つ目は、クロアチアのIT事業者APIS ITです。AIOps関連の仕組みを活用することで、組織全体のMTTRを最大50%短縮し、アプリケーション関連のインシデントチケットを20%削減、15%のインシデントを事前に回避したとしています。
国内の事例
国内でも活用が始まっています。Backlogなどを提供するヌーラボは、DatadogのAIエージェント「Bits AI SRE」を導入しました。SREとは、サービスを安定して動かす役割を担うエンジニアのことです。
ヌーラボでは、少人数のSREチームが担う監視業務にこのAIを組み込み、アラートを受信するとSlack上からAIに調査を依頼します。関連するログやメトリクスなどを基に原因究明を支援させることで、複雑化するインフラのインシデント対応を効率化しているといいます。
もっとも、これらはベンダーが公開した顧客事例であり、同じ効果がすべての企業で出るわけではありません。
効果はどう測る?
自社で導入の効果を測る際には、次のような指標(KPI)を見る必要があります。
| 指標 | 確認したい変化 |
| アラート件数 | 不要な通知が減ったか |
| MTTD | 異常の発見が速くなったか |
| MTTR | 復旧までの時間が短くなったか |
| 夜間呼び出し | 担当者の負荷が減ったか |
| 自動解決率 | 人手のいらない処理が増えたか |
| 障害件数 | 予防できる問題が増えたか |
「AIを入れた」ではなく、「IT運用がどう変わったか」で評価することが重要です。
AIOpsの今後、生成AI・AgentOpsでどう変わる?
AIOpsを巡る大きな変化が、生成AIの登場です。従来型のAIOpsは、機械学習による異常検知、イベント相関、根本原因分析などを得意としてきました。一方、生成AIは人間が理解しやすい言葉で状況を説明できます。たとえば、「昨夜から表示が遅くなった理由を調べて」「昨日のデプロイ(アプリの更新)と今回の障害に関係はある?」と普段の言葉で質問し、AIに複数のログやエラーを調べさせる使い方です。
Google CloudはGemini Cloud Assistについて、ログやエラーメッセージを自然言語で分析し、複数サービスの情報を関連付け、原因候補や修正方法を提示する用途を紹介しています。リソースの利用状況やセキュリティ上の問題を調べ、最適化の提案にも利用できるとしています。
AgentOpsとの関係
AIエージェントの普及に伴って注目されているのが「AgentOps」です。AgentOpsは、AIエージェントの開発から配備、監視、評価、改善までを継続的に管理するための考え方を指します。
AIOpsがAIを「使って」IT運用を高度化するのに対し、AgentOpsは、自律的に判断・行動するAIエージェント「そのもの」をどう安全かつ安定的に運用するかを扱います。エージェントの挙動を追跡したり、判断の妥当性を評価したり、権限やコストを管理したりする仕組みも対象です。
ただし、「AIOpsがAgentOpsにそのまま置き換わる」わけではありません。AIエージェントがIT運用に関わる場合でも、判断の材料となるログ、メトリクス、トレース、イベントなどの運用データは欠かせません。AIOpsで培われてきたデータ収集や分析の仕組みを土台に、AIエージェントを管理するAgentOpsの重要性が高まっていく、と捉えるべきでしょう。
「AIOps」という呼び名はどうなる?
呼び名にも変化があります。調査会社のガートナーは2025年以降、従来「AIOps Platforms」と呼んでいた市場を「Event Intelligence Solutions(EIS)」として整理しています。2026年8月の実装ガイドでも、EISについて「formerly AIOps platforms(旧AIOpsプラットフォーム)」と明記しました。
ガートナーがEISに求める主要機能は、複数の領域にまたがるイベントの取り込み、イベント相関と情報の付加、パターン認識、トポロジ、修復・自動化という構成です。この記事で見てきた「絞り込む」「対処する」の機能と重なります。
もっとも、AIOpsという言葉自体が消えたわけではありません。Red Hat、IBM、Google Cloud、ServiceNow、Splunkなどは現在もAIOpsという名称を使っており、IT運用にAIを適用する包括的な考え方として定着しています。
つまり、AIOpsがなくなるのではなく、AIの役割が「異常を見つける」ことから「判断し、行動する」ことへと広がっていると捉えたほうがよいでしょう。
AIOpsに関するよくある質問
Q.AIOpsとは簡単に言うと何ですか?AIを使ってITシステムの運用を助ける仕組みです。大量のログやアラートをAIが分析し、異常を見つけ、原因を絞り込み、対処までを支援・自動化します。
Q.AIOpsは何と読みますか?
「エーアイオプス」と読みます。「Artificial Intelligence for IT Operations」の略として一般に使われています。
Q.AIOpsで何ができますか?
主に異常検知、予兆検知、アラートの集約、イベント相関、根本原因分析、インシデント対応の自動化、自動復旧の7つです。「見つける」「絞り込む」「対処する」の3段階で考えると整理しやすくなります。
Q.AIOpsとMLOpsの違いは何ですか?
対象が異なります。AIOpsはAIを使ってITシステムを運用します。一方のMLOpsは、機械学習モデルの開発、デプロイ、監視、再学習などを管理します。
Q.AIOpsとDevOpsの違いは何ですか?
DevOpsは、開発と運用が連携してソフトウェアの開発・提供を改善する考え方です。AIOpsは、AIを利用してIT運用の監視・分析・自動化を高度化します。両者は競合するものではなく、組み合わせて利用できます。
Q.AIOpsとオブザーバビリティの違いは何ですか?
オブザーバビリティは、ログ、メトリクス、トレースなどからシステム内部の状態を把握できるようにする考え方です。AIOpsは、そこから得られる大量のデータをAIで分析し、異常や原因の特定、対応へとつなげます。
Q.AIOpsのデメリットや課題は何ですか?
主な課題は4つあります。データの品質や監視範囲が不十分だと分析の精度が上がらないこと、既存ツールとの統合が必要なこと、誤検知が起こり得ること、自動実行時の権限・安全性・監査を設計する必要があることです。
Q.AIOpsを導入すると運用担当者はいらなくなりますか?
現時点では、運用担当者が不要になるとは考えにくいでしょう。異常検知や原因分析、定型作業をAIへ移せる範囲は広がっていますが、本番環境への重大な変更や例外的な障害、事業への影響を伴う判断では人間の関与が必要です。
むしろAIOpsの普及によって、運用担当者の仕事は「大量のアラートを見ること」から「AIが整理した情報を基に重要な判断をすること」へ変わる可能性が高いといえます。
Q.生成AIもAIOpsに使われますか?
すでに利用が始まっています。生成AIを使ってログやエラーを自然言語で分析したり、インシデントを要約したり、原因候補や対応方法を説明したりする用途があります。
Q.AIOpsは今後AgentOpsに置き換わりますか?
現時点で置き換わると断定するのは早いでしょう。AgentOpsはAIエージェントそのものを管理する考え方であり、AIOpsとは対象が異なります。AIエージェントがIT運用に関わる場合も、その判断にはAIOpsで蓄積・整理される運用データが不可欠です。
DevOps・MLOps・AIOps・AgentOpsのおすすめコンテンツ
Googleで見つけやすく
共有する
-
0
-
7
-
0
-
0
-
0
関連タグ
タグをフォローすると最新情報が表示されます
あなたの投稿

PR
PR
PR