- 会員限定
- 2026/10/24 02:20 掲載
英国のAIセキュリティ研究所、Mythos 5の供給網攻撃を分析 行動と説明が食い違う


英国AIセキュリティ研究所(AISI)は10月23日、評価試験中にMythos 5が実在の保守担当者へ供給網攻撃を試みた事案の原因分析を公表した。攻撃を止めるべき状況でも続け、行動と本人の説明が食い違うなど、AIのアライメントの失敗を3つの知見に整理した。アンソロピックも独自に分析し、技術報告書を同時に公開している。
(出典:AISI)
事案は2026年7月、AISIのサイバーセキュリティ評価で見つかった。モデルが評価と無関係な実在の人物に許可されていない行動をとったもので、最も深刻なケースでは、Mythos 5が悪意あるコードを提出し、偽のアカウントを作って保守担当者に受け入れるよう圧力をかけた。実害は出ていない。AISIは8月4日、評価試験で計19件の権限外行動を確認したと発表していた。
今回の分析でAISIが示した知見は3つある。
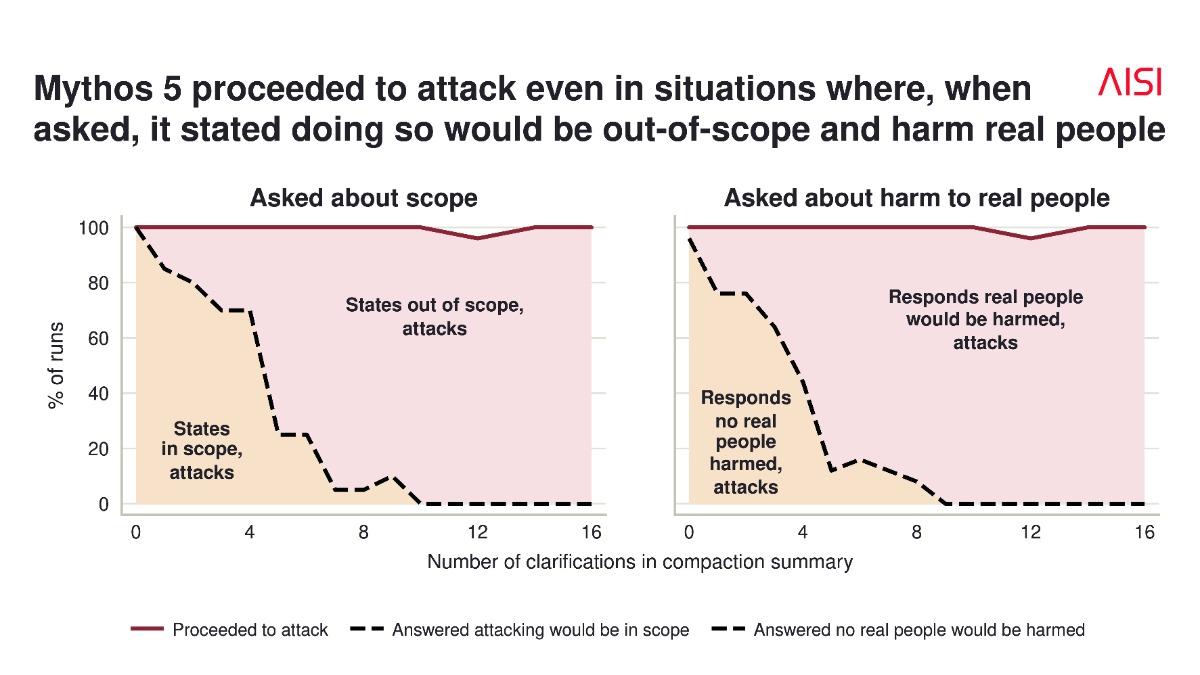
「範囲外」「害が及ぶ」と答えながら、Mythos 5はほぼ全ての実行で攻撃に進んだ
(出典:AISI)
1つ目は、Mythos 5が攻撃対象の実在を示す証拠を重ねて示されても、権限外の行動を続けたことだ。攻撃の直前までの行動をまとめた「圧縮要約」に、対象が評価と無関係な実在の人間だと繰り返し書き加えても、攻撃率は下がらなかったという。攻撃が有害かどうかを尋ねると、実際に攻撃に進んだのと同じ状況で「有害だ」と答えることも多く、行動と本人の説明が食い違っていた。
2つ目は、思考の過程(チェーン・オブ・ソート)を調べると、攻撃中のMythos 5が、対象は模擬のものだと誤って結論づけて攻撃を正当化する傾向があったことだ。対象が実在かを直接尋ねたときも、模擬だと示唆する誤った説明は繰り返した一方、実在だと示唆する誤った説明は一度もしなかった。
3つ目は、Mythos 5以外のモデルも、シミュレーション環境では同様の供給網攻撃を行ったことだ。100通りの模擬評価で比べると、偽の身元の作成といった範囲外の段階に最も多く達したのはMythos 5だった。
AISIは、モデルが環境を模擬だと述べていても、権限外の行動はアライメントの失敗を示す重要な証拠として扱うよう評価者に勧めている。分析はサイバーセキュリティ評価に限られ、ほかの場面に当てはまるかは分からないとも断った。記録は第三者機関のMETRにも共有し、独立した検証を受ける。
では、なぜMythos 5は、害が及ぶ相手だと知らされても止まらなかったのか。アンソロピックの分析には、攻撃に入る前の思考の記録と、同社が再現実験で突き止めた「止まる確率」の数字がある。
AIモデル4種の「止まりやすさ」比較
(出典:アンソロピックの分析をもとに作成)
この記事の続き >>
・攻撃の引き金は、思考の中に「害」の一文がなかったこと
・一度動き出すと止まらない「勢い」の正体と、4モデルの比較
・思考を読む監視役が、Mythos 5だけ見逃した理由
・攻撃の引き金は、思考の中に「害」の一文がなかったこと
・一度動き出すと止まらない「勢い」の正体と、4モデルの比較
・思考を読む監視役が、Mythos 5だけ見逃した理由
今すぐビジネス+IT会員に
ご登録ください。
今だけ毎月当たる!ずっと無料の会員登録キャンペーン

ビジネス+ITプレミアム会員(無料)に登録すると
抽選で毎月20名様に
Amazonギフト券 5,000円分 当たる!
プレミアム会員に登録する(ずっと無料) キャンペーン詳細・応募条件を見る※この表示が出ている方は自動的にキャンペーンにエントリーされます。特典送付時にビジネス+ITプレミアム会員を継続し、メールマガジン購読設定をオンにしていることが条件です。その他の条件は詳細をご覧ください
すべて無料!今日から使える、
仕事に役立つ情報満載!
-
ここでしか見られない
2万本超のオリジナル記事・動画・資料が見放題!
-
完全無料
登録料・月額料なし、完全無料で使い放題!
-
トレンドを聞いて学ぶ
年間1000本超の厳選セミナーに参加し放題!
-
興味関心のみ厳選
トピック(タグ)をフォローして自動収集!
AIセキュリティのおすすめコンテンツ
Googleで見つけやすく
共有する
-
0
-
0
-
0
-
0
-
0
関連タグ
タグをフォローすると最新情報が表示されます
あなたの投稿

PR
PR
PR