- 2026/09/22 10:03 掲載
米SpaceXAIが「Grok 4.7」発表、価格据え置きで法務・電気設計のベンチマーク改善


米SpaceXAIは9月21日、大規模言語モデル「Grok 4.7」を発表した。コーディングと知識労働に向けた同社最上位のモデルで、前世代のGrok 4.6と同じ価格・速度で提供する。ベースモデルを大型化し、強化学習を数時間かかる難問へ重点的に回したという。電気設計や法務のベンチマークでは比較対象の中で最高値を示した。
(出典:SpaceXAI)
料金は入力100万トークンあたり2ドル(約310円、1ドル156円換算)、出力100万トークンあたり6ドルに据え置いた。同社が比較対象として挙げた競合モデルは入力4?10ドル、出力20?50ドルで、価格性能比を前面に押し出した格好だ。出力速度を2倍にした高速版も用意するが、こちらは料金も2倍となる。
性能向上の中身は、ベースモデルの大型化と強化学習の長期化だという。学習に使うタスクの構成をより難しいほうへ寄せ、完了までに数時間かかる問題に重みを置いた。その結果、自らの出力を検証する力と、長い文脈を扱う力が高まったとしている。対話用エージェント「Grok Bot」の実行環境をモデル自身が理解するよう訓練した点も新しい。
(出典:SpaceXAI)
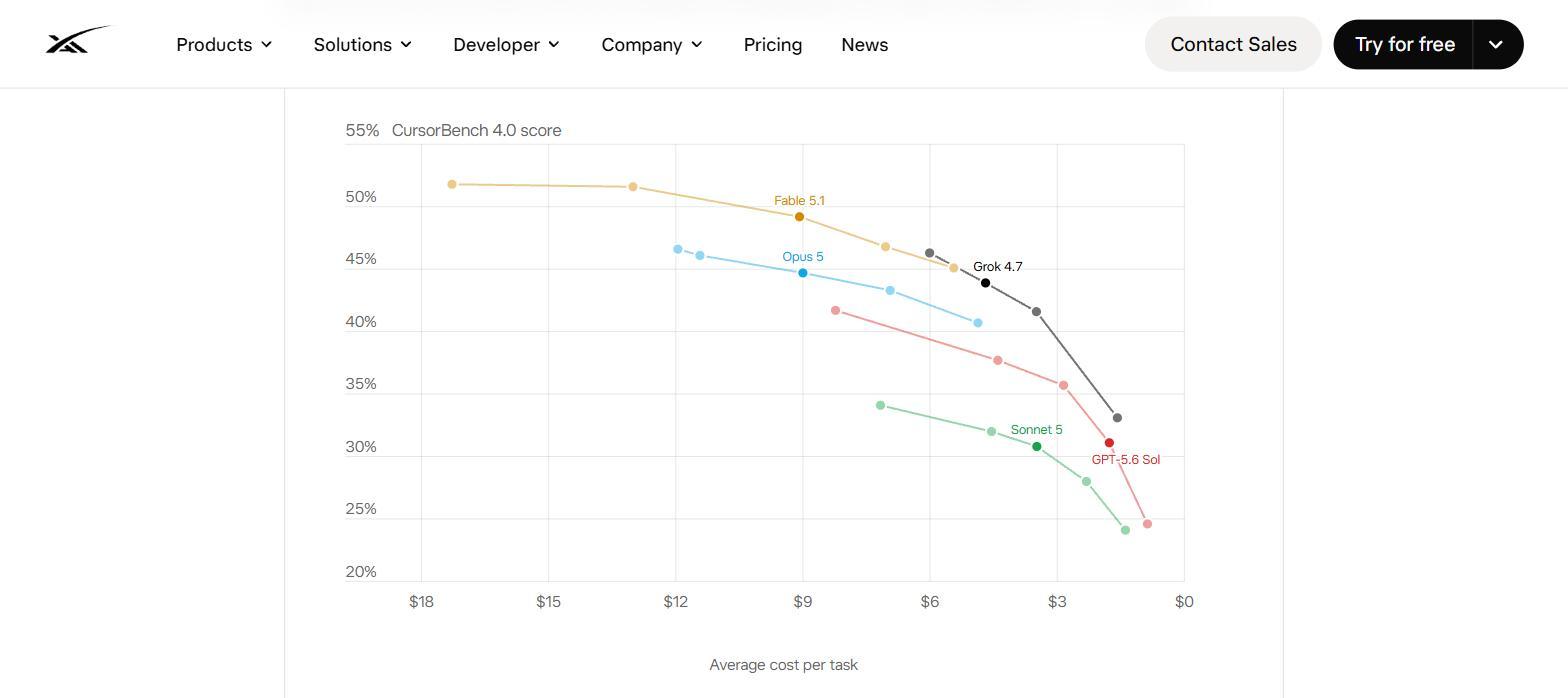
ベンチマークでは、長時間のコーディングを課すCursorBench 4.0で46.3%を記録し、Grok 4.6の40.4%から伸びた。電気設計のEEBenchは64.0%、法務作業のHarvey Legal Agent Benchmarkは19.6%で、いずれも同社が並べた4モデルの中で最高値。一方、ターミナル操作を長時間続けるTerminal-Bench 4.0は38.0%にとどまり、57.9%の「Fable 5.1」には届いていない。弁護士や看護師、財務アナリストの実務を模したGDPvalでも、Eloスコアは1695でFable 5.1の1735に次ぐ2番手だった。
安全性では、セーフガードの仕組みを全面的に刷新した。危険なサイバータスクを測るHackerBench v0.3では、リスクのあるプロンプトの通過率を3.3%に抑えつつ、正当なセキュリティ業務は妨げないという。バイオセーフティの指標でも62.4%で首位に立った。一部のセキュリティ企業には、招待制で攻撃側の検証機能を開放している。
提供はCursorとGrok Buildで同日開始した。Grok API経由のほか、外部のコーディング環境やモデルルーター、クラウド基盤からも利用できる。同社は8月に「Grok 4.6」を出したばかりで、約40日での刷新となる。
AI・生成AIのおすすめコンテンツ
Googleで見つけやすく
共有する
-
0
-
0
-
0
-
0
-
0
関連タグ
タグをフォローすると最新情報が表示されます
あなたの投稿

PR
PR
PR